Gemini 4 Neon 编程能力如何?CursorBench 4.1 跑分、成本与 Claude 对比
Gemini 4 Neon 的编程能力究竟如何?本文结合 CursorBench 4.1、Artificial Analysis 和 Zapier 的公开评测,对比 Gemini 4 Neon、Claude Fable 5.2 与 Opus 5.5 的编程 Agent 表现、任务完成成本和执行效率,并分析不同思考档位的性价比,以及 Carbon、Hydrogen 等模型的适用场景,帮助开发者选择更合适的 AI 编程模型。
先给结论:四个最常见问题的直接答案
Gemini 4 Neon 是什么?Google 面向复杂编码、知识工作和科学工作流的平衡型模型,位于 Hydrogen 与 Carbon 之间;在 Antigravity 中可选择 Orchestrator (Neon),由 Neon 规划、Hydrogen 实现;这是一段对话中的双模型交接。
API 多少钱?Standard 输入 $3、输出 $15/百万 Token;Batch/Flex 为 $1.50/$7.50;Neon 不在 Gemini API 免费层中。
比 Claude 强吗?CursorBench 4.1 的多文件 Agent 任务里,Neon XHigh 得 65.4%,高于 Fable 5.2 Max 的 61.3% 和 Opus 5.5 Max 的 58.1%;这只代表该测试集,不等于所有编程任务全面领先。
怎么接入?使用 Google AI Studio 的 Gemini API Key、官方 google-genai SDK 和模型 ID gemini-4-neon;长输出、思考档位、缓存和工具调用还要遵守专门的 API 约束。Antigravity 订阅入口与 API 账单分开计算。
资料核验日期:2026 年 11 月 19 日|作者:灵眸 AI 技术观察|数据来源分为 Google 官方资料、第三方评测和开发者讨论;本文未使用真实 API Key 对 Neon 进行端到端实测。
Gemini 4 Neon 值得用吗?如果你的任务是多文件编程、复杂 Agent 执行、企业知识工作或科研分析,它值得进入候选名单;如果是日常编码和普通 Agent 循环,可以先测试 Hydrogen;如果是大批量、低延迟分类和路由,Google 官方建议优先考虑 Gemini 3.5 Flash-Lite。Neon 的 Gemini API 标准价为每百万输入 Token 3 美元、输出 Token 15 美元,支持 Low、Medium、High、XHigh 四档思考,模型 ID 是 gemini-4-neon。它没有免费 API 层,也不支持显式上下文缓存,不能只看“1M 上下文”或综合跑分决定迁移。
Gemini 4 Neon 是什么?和 Carbon、Hydrogen、Argon 有什么区别?
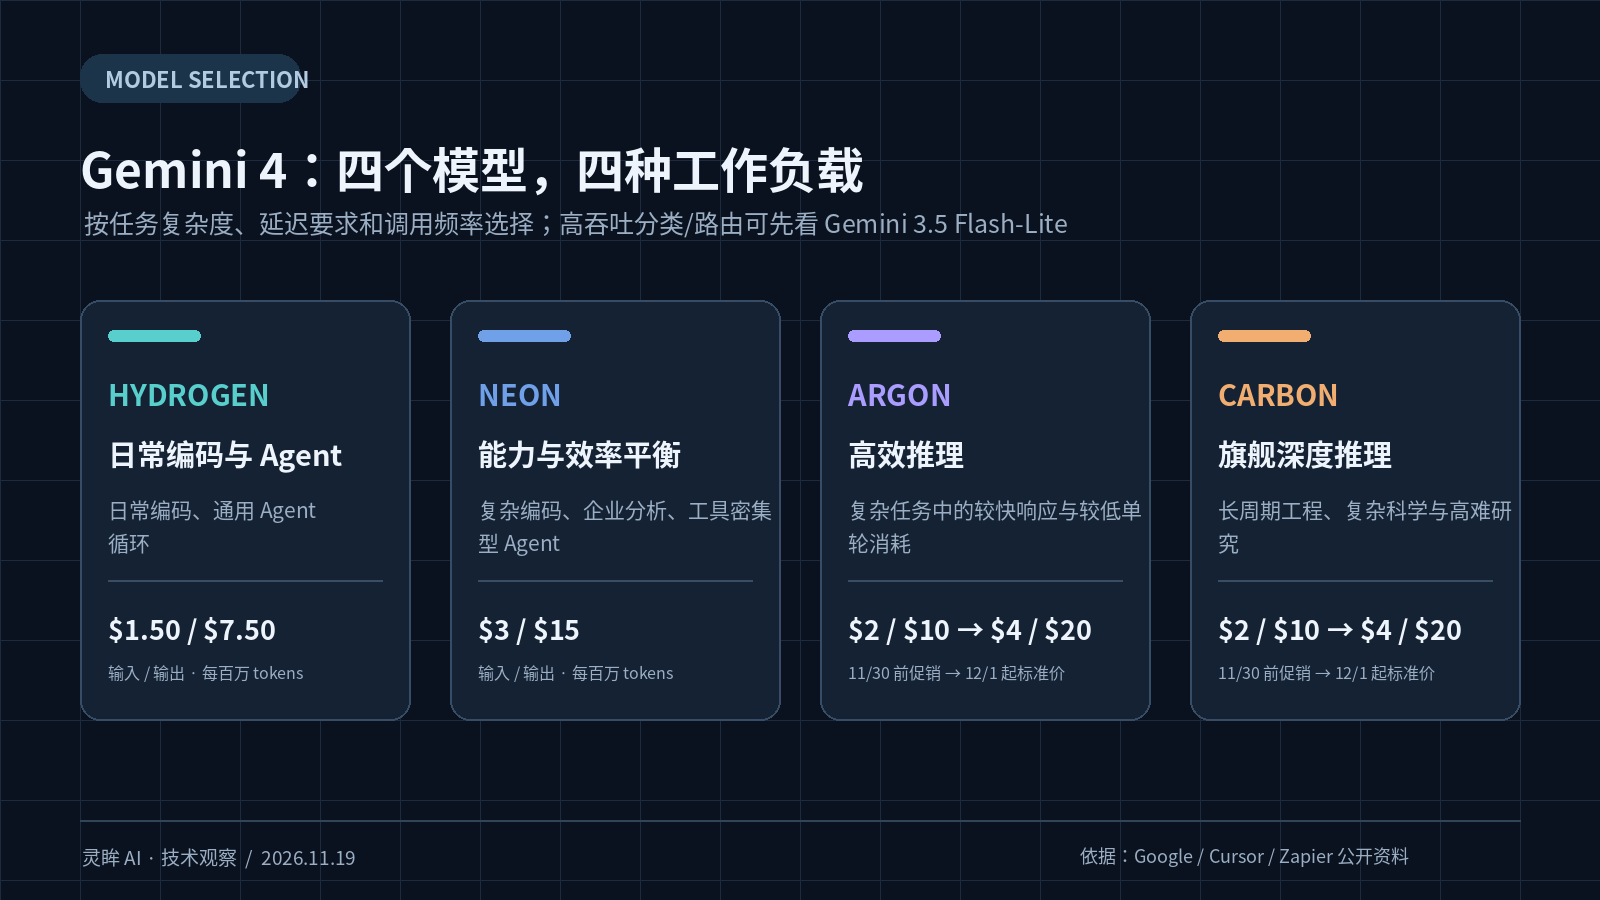
Neon 不是简单的“低价 Carbon”,而是 Google 为高频复杂任务设计的中间层模型。Google DeepMind 的模型卡将 Neon 描述为适合复杂编码、分析推理和生产级企业工作流的模型,并明确说明 Neon 是基于 Carbon 适配而来:Carbon 继续处理最难、周期更长的任务;Hydrogen 负责速度敏感的日常执行;Neon 试图在推理深度、响应速度和单任务成本之间取得平衡。Argon 则被 Google 定位为相对高效的 Gemini 4 推理模型,官方价格页称其相较 Carbon 在复杂编码、Agent、数学和科学任务中能以更快响应和更低单轮 Token 消耗提供 Gemini 4 能力。Google DeepMind:Neon Model Card · Google Gemini API 官方价格表
| 模型 | 官方定位 | 优先测试的任务 | 标准输入/输出价(美元/百万 Token) |
|---|---|---|---|
| Gemini 4 Hydrogen | 速度与效率优先 | 日常编码、通用 Agent 循环、工具执行 | $1.50 / $7.50 |
| Gemini 4 Neon | 能力与效率平衡 | 多文件编码、复杂工具调用、企业分析、科研推理 | $3 / $15 |
| Gemini 4 Argon | 高效推理 | 需要较强推理、又希望降低相对 Carbon 的单轮消耗 | $2 / $10(至 11/30);之后 $4 / $20 |
| Gemini 4 Carbon | 旗舰深度推理 | 长周期工程、复杂科学研究、高难度多阶段任务 | $2 / $10(至 11/30);之后 $4 / $20 |
表 1|价格为 Google Gemini API 官方 Standard Tier 标价,不是第三方平台报价,也不是 Antigravity 订阅额度。Hydrogen、Neon、Argon、Carbon 的定位取自 Google 模型卡与模型选择文档;价格核验日期为 2026-11-19。官方价格表 · Antigravity 模型选择文档
如果任务是海量分类、路由、摘要和结构化字段提取,不要把 Hydrogen 和 Flash-Lite 混成一个定位:Google 的模型选择指南将 Hydrogen 作为日常编码和 Agent 工作流的默认候选,把 Gemini 3.5 Flash-Lite 留给高吞吐、低延迟任务。Argon 则是强调较快响应和较低单轮 Token 消耗的高效推理模型。四个元素名称并不构成严格的线性能力排序,模型选择应看任务负载,而不是只按名字排队。Google:Choosing between Neon, Carbon, Hydrogen, and other models
需要注意,Google 在不同产品入口里提供的模型范围并不完全相同。Gemini API、Gemini App、Google AI Pro/Ultra 订阅和 Antigravity 的使用资格不是同一回事;某个订阅计划可以在 App 中选择 Neon,不代表它自动包含免费的 API 调用额度。Neon 的 Gemini API 标准价格页明确标注 Free Tier 不可用,所有输入、输出和思考 Token 都按对应计费规则计算。Google 官方定价与免费层说明
Gemini 4 Neon 在 Antigravity 里怎么和 Hydrogen 协作?
Google 的 Orchestrator (Neon) 不是简单的模型路由,也不是多个 Agent 并行群聊,而是在同一段对话里让 Neon 负责规划与复核、Hydrogen 负责具体实现。Antigravity 官方文档说明,Orchestrator (Neon) 会先由 Neon 只读分析代码库、拆解任务并制定实施计划,再交给 Hydrogen 修改文件、运行构建和测试;遇到验证连续失败或计划未覆盖的情况时,控制权会回到 Neon 修订计划。整个交接在一次 Agent 任务中自动完成,不需要开发者手动切换模型。Google Antigravity:Choose a model / Orchestrator
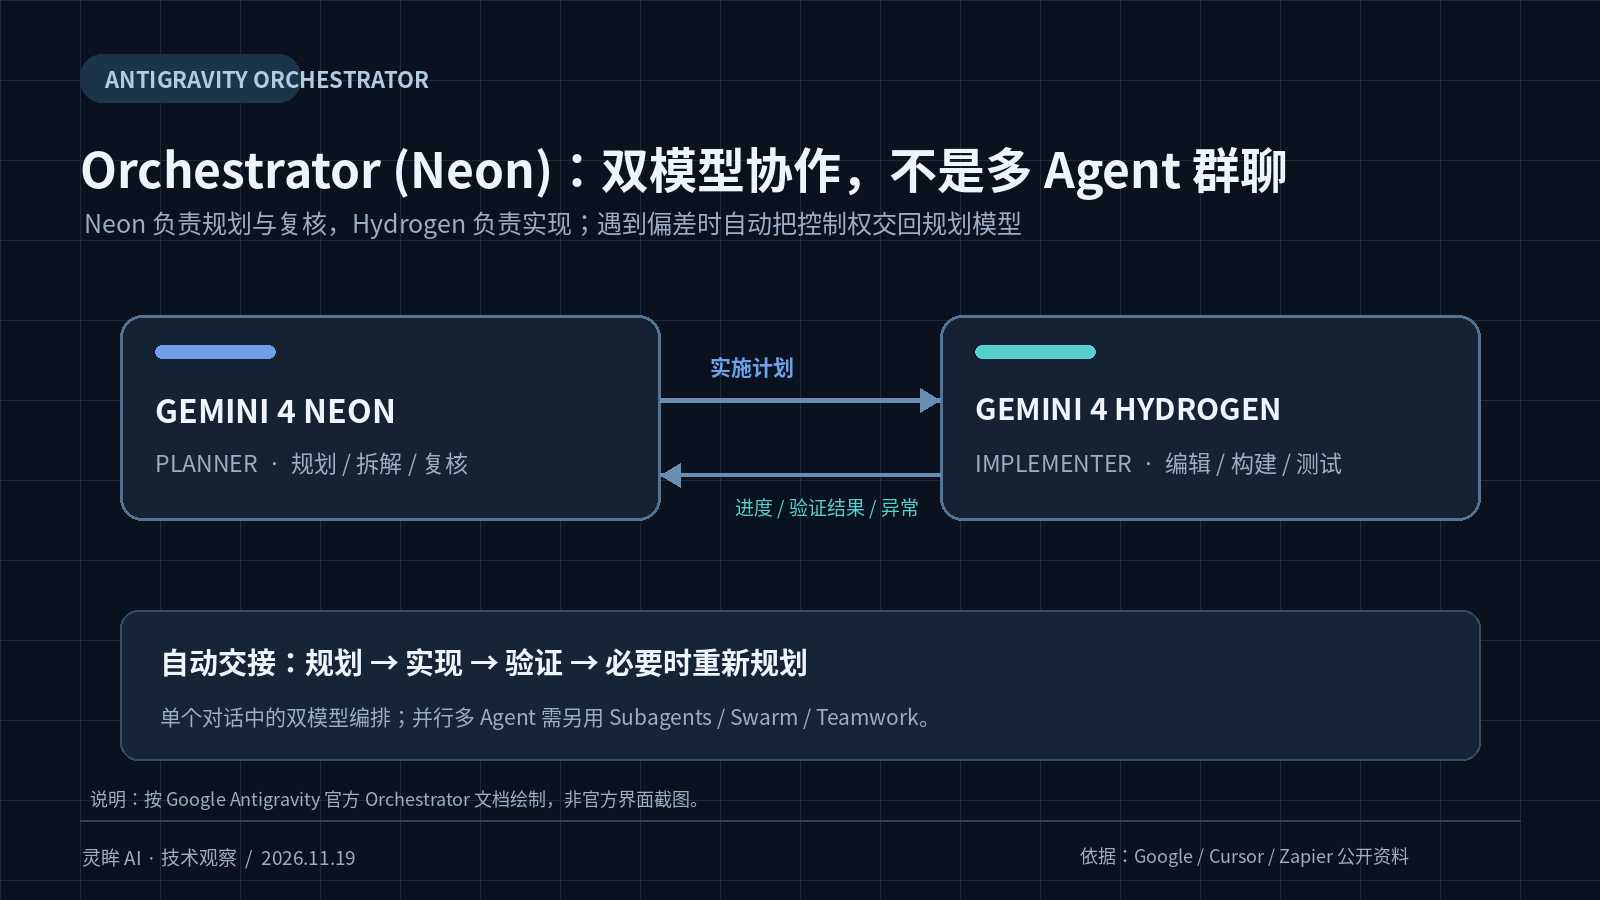
这与单独调用 Neon API 有本质区别。直接选择 Neon,意味着所有模型推理步骤都由 Neon 完成,适合每个中间步骤都需要更深推理的复杂分布式系统设计、细微并发问题或跨仓库迁移;选择 Hydrogen,则适合无需单独规划阶段的日常维护、依赖升级、样板代码和明确的小任务。Google 将 Orchestrator 列为日常功能开发、Bug 修复、重构和多文件调试的推荐默认选项。
Orchestrator 也不等于 Swarm。官方说明它在一个对话中由两个模型交接执行;若要多个 Agent 并行工作、互相检查,应使用 Subagents、Swarm、Boost 或 Teamwork。Orchestrator 使用固定配置,不能单独调节其 thinking level;需要指定推理档位时,应直接选择 Neon、Carbon、Argon 或 Hydrogen。
还要区分不同入口的上下文限制:Gemini API 的 Neon 模型规格是统一 1,048,576 Token;Antigravity 文档列出的 Neon 上下文窗口最高为 512K Token。不能把 API 规格直接套用到 IDE 或订阅产品中。Antigravity 的 Neon 与 Orchestrator (Neon) 也不是免费计划功能:官方模型选择表列出 Google AI Pro(付费计划或符合条件设备试用)、Google AI Ultra;Neon 模型本身还列有 Gemini Enterprise 可用性,而 Orchestrator (Neon) 不在 Enterprise 可用列表中。Antigravity 模型与计划可用性
Neon 的输入能力包括文本、图像、视频、音频和 PDF,输出为文本;模型支持 Function Calling、Code Execution、Computer Use、File Search、Google Search/Maps Grounding、Structured Output 和 URL Context,但不支持图像生成、音频生成或 Live API。对需要阅读实验图片、视频资料或 PDF 文档的团队,这些输入能力有实际价值;若需求是直接生成图片或实时语音交互,则应另选对应模型。Google AI Studio:Gemini 4 Neon 模型规格
Gemini 4 Neon 和 Claude Fable 5.2、Opus 5.5 哪个更适合编程?
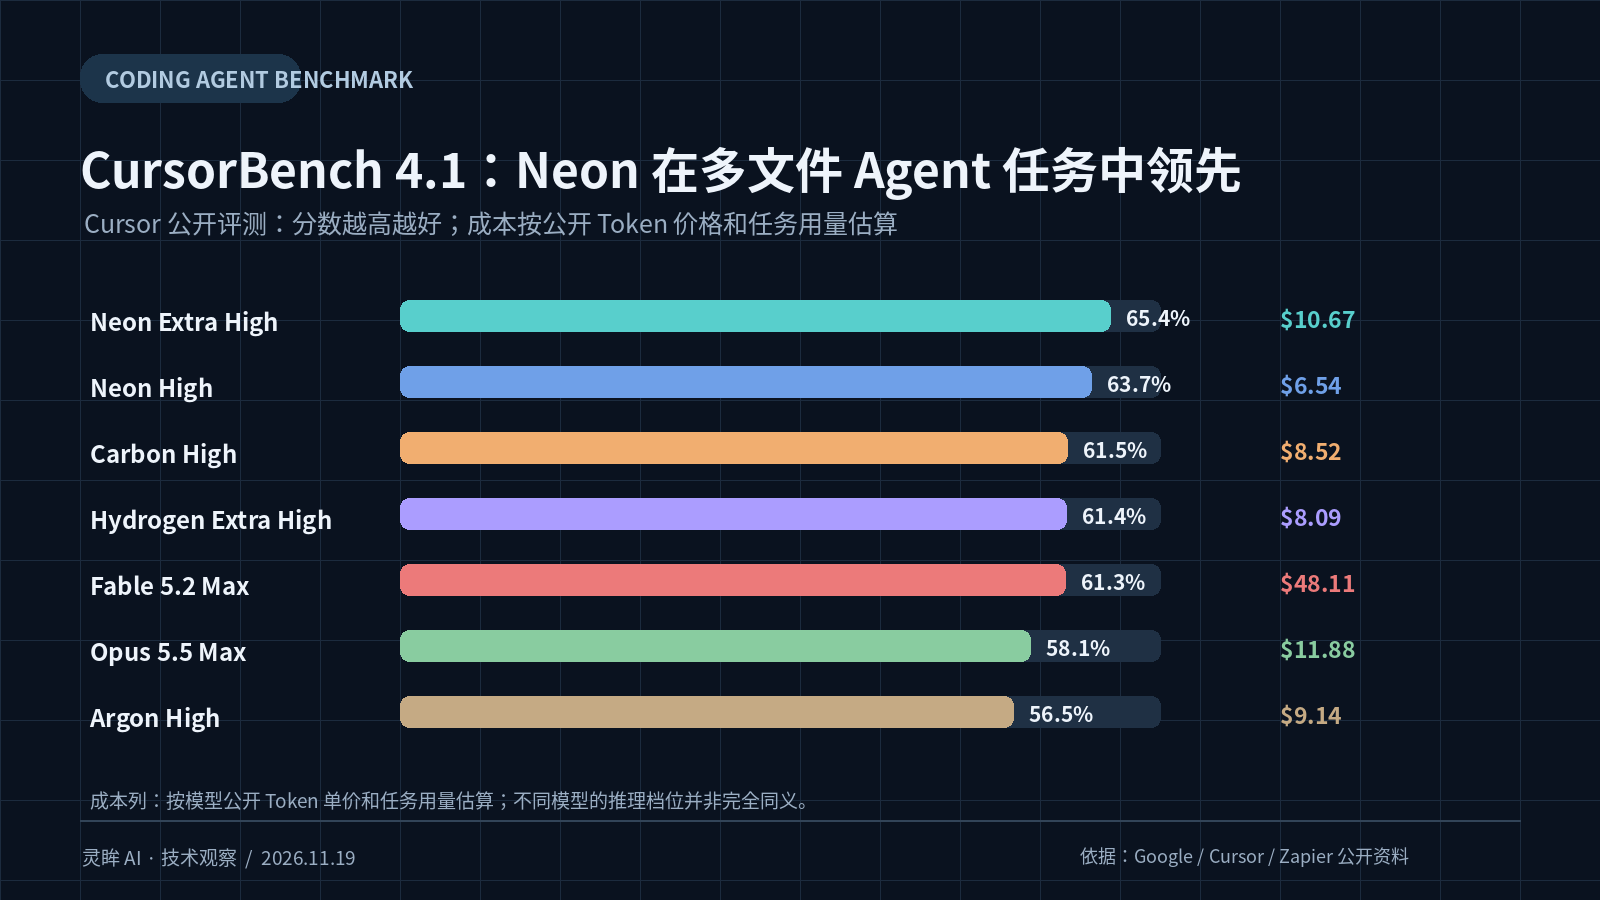
如果关注多文件 Agent 编程,CursorBench 4.1 是比单纯综合跑分更贴近问题的一组公开数据。Cursor 表示,CursorBench 4.1 使用真实 Cursor 会话中抽象出的模糊、多文件任务;在这组测试里,Neon Extra High 得 65.4%,Neon High 得 63.7%,分别位列前两名。Claude Fable 5.2 Max 为 61.3%,Opus 5.5 Max 为 58.1%。同一页面还记录了每项任务的 Token 消耗、步骤数和任务成本。Cursor 官方 CursorBench 4.1 榜单
| 模型与档位 | CursorBench 4.1 | 估算任务成本 | Token 数 | 步骤数 |
|---|---|---|---|---|
| Gemini 4 Neon Extra High | 65.4% | $10.67 | 136,273 | 73 |
| Gemini 4 Neon High | 63.7% | $6.54 | 88,596 | 56 |
| Gemini 4 Neon Medium | 57.7% | $3.07 | 47,059 | 41 |
| Gemini 4 Argon High | 56.5% | $9.14 | 135,038 | 118 |
| Gemini 4 Carbon High | 61.5% | $8.52 | 114,518 | 97 |
| Gemini 4 Hydrogen Extra High | 61.4% | $8.09 | 205,981 | 113 |
| Claude Fable 5.2 Max | 61.3% | $48.11 | 541,003 | 295 |
| Claude Opus 5.5 Max | 58.1% | $11.88 | 213,070 | 144 |
表 2|来源:CursorBench 4.1,2026-11-19 查询。模型的 Extra High、Max 等推理档位不是跨厂商统一标准;成本由 Cursor 按模型公开的每百万 Token 价格(含输入、缓存读写和输出)乘以任务用量估算,并非服务商实际账单;Cursor 也提醒小幅分数差异未必具有统计显著性;其 11 月 18 日更新调整了指令遵循题并延长 Agent 时间上限,不能把 CursorBench 4.1 与旧版 4.0 混为一谈。
Neon 是否在所有基准上都领先?
不是。Google DeepMind 的模型卡同时列出了 Neon、Claude Opus 5.5 和 GPT-6.2 Sol 的多个测试结果。Neon 在 CursorBench 4.1、AutomationBench 和部分科学推理项目领先,但在 Terminal-Bench 4.1 和 FrontierCode 2.0 上略低于 Opus 5.5,在 Chartography 上低于 GPT-6.2 Sol。由于这组结果来自 Google 官方模型卡,应视为厂商公布的评测,而不是独立复测。AA Index v5.0.1 本身由九项评测构成,因此它的综合分数也不等于单一编程能力。
| Google 模型卡评测 | Neon | Claude Opus 5.5 | GPT-6.2 Sol | 本组结果 |
|---|---|---|---|---|
| CursorBench 4.1 | 65.4% | 58.1% | — | Neon 领先 Opus |
| Terminal-Bench 4.1 | 65.2% | 65.8% | 61.5% | Opus 略高 |
| FrontierCode 2.0 | 46.2% | 47.3% | 43.8% | Opus 略高 |
| AutomationBench | 56.3% | 42.5% | 41.3% | Neon 领先 |
| Chartography | 73.5% | 66.3% | 75.1% | GPT-6.2 Sol 领先 |
| RiemannBench | 84.0% | 80.0% | 80.0% | Neon 领先 |
表 2A|来源:Google DeepMind Gemini 4 Neon Model Card,结果标注为 2026 年 11 月。不同 Benchmark 的题型和评测工具不同,百分比不能跨表直接比较。
这组数据支持一个有限但有用的结论:在 CursorBench 4.1 的多文件 Agent 任务里,Neon 的分数和任务成本组合有竞争力,尤其 Neon High 的任务成本低于 Neon Extra High,同时仍取得 63.7% 的成绩。但它不能证明 Neon 在代码补全、简单 Bug 修复、所有语言、所有仓库或 Claude Code 环境里都更好。Fable 5.2 Max 与 Neon XHigh 的任务成本差距也受到各自模型输出 Token、Agent 步骤和计费价格影响,不能把成本差直接归因于模型效率一个因素。
如果你正在比较 Claude 模型,可以继续阅读灵眸博客的 《Claude Fable 5.2、Fable 5.1、Opus 5.5 怎么选?价格、跑分与实际使用体验对比》。两篇文章的评测口径不同:Fable 文章重点讨论 Claude 家族的官方基准、AA 任务成本和迁移差异;本文则用 CursorBench 的同一任务集补充跨模型比较。
Gemini 4 Neon 综合跑分 61 分,为什么排名会变?
61 分是 Artificial Analysis Intelligence Index v5.0.1 的 xhigh 配置分数,但“全球第三”不是永久排名。Google 在 11 月 18 日发布文章时称 Neon 以 61 分排名第三;截至 11 月 19 日查询 Artificial Analysis 的实时模型页,页面显示 61 分、排名第 6/96。模型排名会随着新模型和评测配置加入而变化,写作时应把分数、配置、榜单版本和查询日期放在一起,而不是只保留一个名次。Google 发布时的排名说明 · Artificial Analysis 实时模型页
| AA 指标 | Neon XHigh 数据 | 正确理解方式 |
|---|---|---|
| Intelligence Index | 61 分;11/19 实时榜单第 6/96 | 发布日 Google 曾报告第 3;排名会动态变化 |
| Time to first answer token | 56.51 秒 | 该指数任务的首个回答 Token 延迟,不是普通请求固定延迟 |
| Output speed | 约 110 tokens/s | 生成速度不等于任务完成速度 |
| Time per Intelligence Index task | 21.5 分钟 | AA 指数任务的平均耗时 |
| AA 指数任务估算成本 | $6.44 | AA 评测任务的估算成本,不是实际账单或每次 API 请求的统一价格 |
| 输出 Token 总量 | 283M | 该指数评测集合的总输出量,反映高推理档位较高的输出消耗 |
表 3|来源:Artificial Analysis:Gemini 4 Neon,2026-11-19 查询。该页面同时指出 Neon XHigh 在 AA 指数任务上耗时高于同类模型中位数,且输出量较大;不能只摘录 61 分而忽略成本和延迟。
这也是为什么综合榜单不能代替业务验收。对于在线客服,首 Token 延迟可能比综合分数更重要;对于异步科研分析,完成率和证据准确性可能更重要;对于代码 Agent,人工返工时间、工具调用次数和最终测试通过率才是更接近真实价值的指标。
Zapier 657 项任务:Neon 应该使用 High 还是 XHigh?
Zapier 的 AutomationBench 说明,Neon 的思考档位应按任务失败代价选择,而不是默认所有请求都开到最高。Zapier 在 2026 年 11 月 17—18 日对 Neon 的四档思考强度分别运行 657 项任务,覆盖销售、营销、运营、客服、财务和人事,任务环境由 47 个模拟应用组成;任务只有在模拟业务系统的最终状态满足全部断言时才算通过。XHigh 完成率最高,为 56.3%;但从 Low 升到 XHigh,估算单任务成本从 $0.40 增至 $1.69。Zapier:Gemini 4 Neon AutomationBench 报告
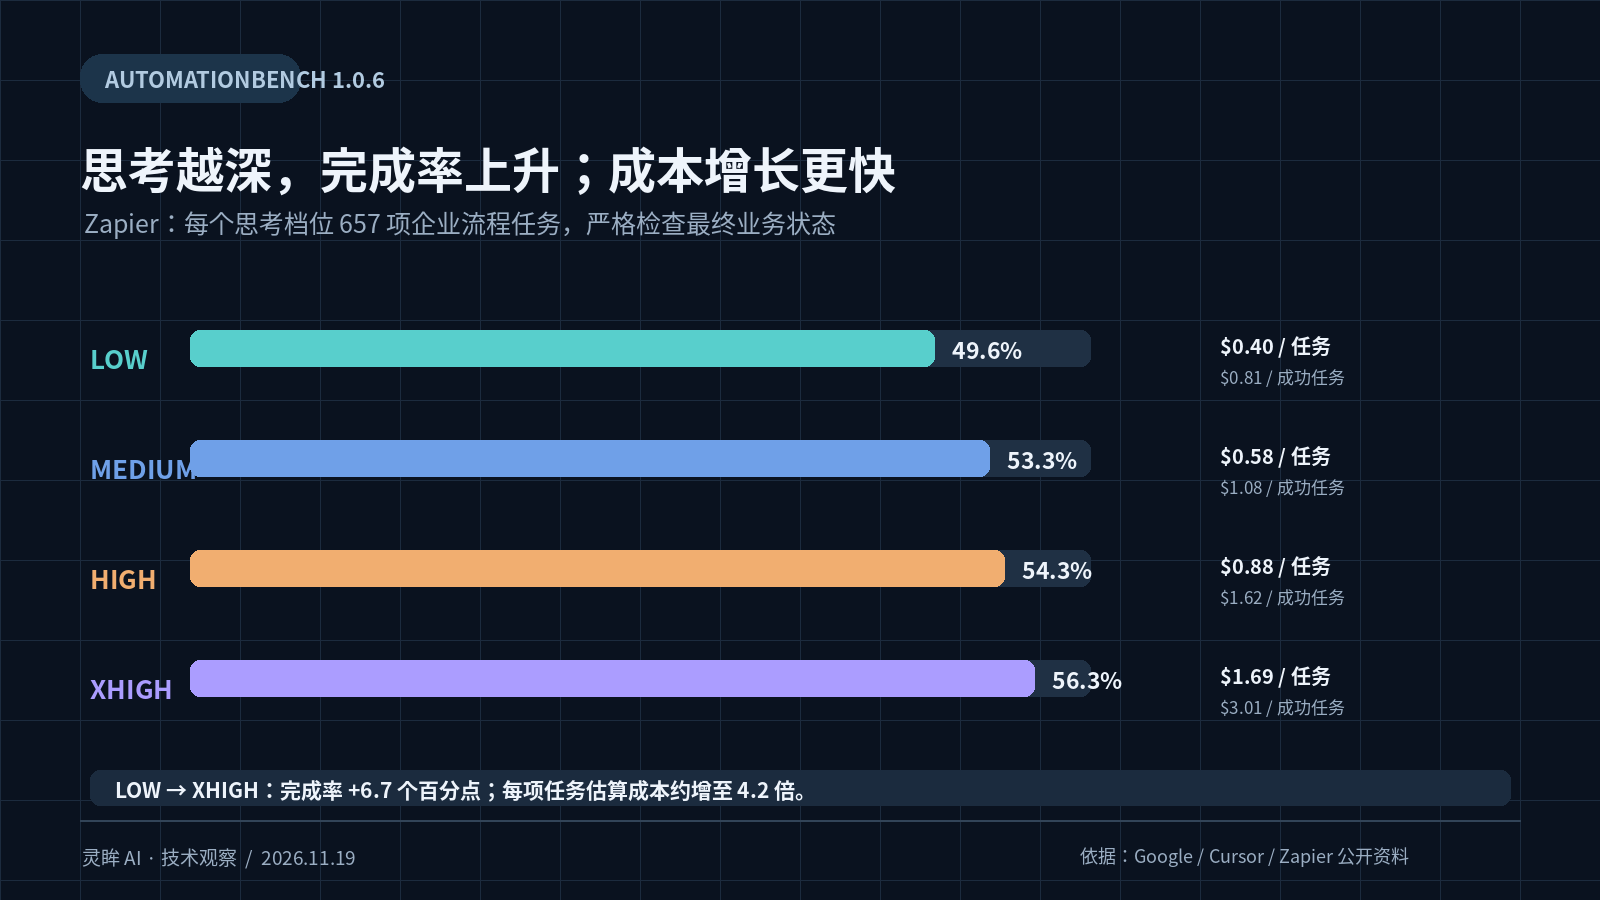
| 思考档位 | 完成任务数 | 完成率 | 估算成本/任务 | 估算成本/成功任务 |
|---|---|---|---|---|
| Low | 326 / 657 | 49.6% | $0.40 | $0.81 |
| Medium | 350 / 657 | 53.3% | $0.58 | $1.08 |
| High | 357 / 657 | 54.3% | $0.88 | $1.62 |
| XHigh | 370 / 657 | 56.3% | $1.69 | $3.01 |
表 4|来源:Zapier AutomationBench 1.0.6。成本为按 Google 公开单价和缓存读取假设计算的估算值,不是 Google 实际账单;成功任务成本 = 所有任务的总估算开销 ÷ 通过任务数,失败任务成本也计入。
对任务分级比统一设置 XHigh 更合理。大量重复性数据分类、字段抽取和简单客服流程,可以先测试 Low 或 Medium;需要跨系统读写、处理多个工具结果的业务流程,可以从 High 开始;涉及复杂代码根因分析、数学证明或多阶段科研推理,再评估 XHigh 是否带来足够的成功率提升。
Zapier 的报告还提醒,HR 是 Neon 在该测试中相对较弱的业务领域,而 Marketing、Finance 和 Sales 的成绩更好。因此“企业自动化表现强”不代表它在每个部门、每种任务上都同样可靠。团队应把自己的真实失败案例放进测试集,而不是只选公开基准表现较好的任务。
Gemini 4 Neon API 多少钱?Carbon 促销期为什么出现价格倒挂?
Neon 官方 Standard API 价格为输入 $3、输出 $15/百万 Token;缓存命中输入价格为 $0.15/百万 Token。Neon 不提供免费 API 层,思考 Token 计入输出费用。Google 还列出 Batch 和 Flex 价格 $1.50/$7.50、Priority 价格 $5.40/$27;是否适合某个业务,需要结合延迟要求和请求类型判断。Google Gemini API 官方价格表
| 计费模式 | 输入价 | 输出价(含思考 Token) | 适用说明 |
|---|---|---|---|
| Standard | $3.00 | $15.00 | 缓存命中输入 $0.15;Neon 无免费层 |
| Batch | $1.50 | $7.50 | 缓存命中输入 $0.075;适合异步批量任务 |
| Flex | $1.50 | $7.50 | 缓存命中输入 $0.075;按 Flex 服务条件使用 |
| Priority | $5.40 | $27.00 | 缓存命中输入 $0.27;更高优先级档位 |
表 5|Google 官方价格表,单位美元/百万 Token,查询日期 2026-11-19。缓存价格另计;Grounding with Google Search、Maps 等工具调用也可能产生独立费用。
短期价格倒挂来自 Carbon 和 Argon 的首发促销,而不是 Neon 的长期标准价更高。Google 价格表显示,Carbon、Argon 在 2026 年 11 月 30 日前的 Standard 输入/输出价为 $2/$10,计划从 12 月 1 日起恢复为 $4/$20。Neon 当前为 $3/$15,所以 11 月剩余时间里,Neon 单价高于促销中的 Carbon;按 12 月 1 日之后的标准价格,Neon 才比 Carbon 低 25%。这也是文章必须标注价格核验日期的原因。
Neon API 的一次调用大概多少钱?
可以先用一个简单例子估算基础费用:假设一次任务使用 100,000 个未缓存输入 Token、20,000 个输出 Token(输出已包含思考 Token),按 Standard 价格计算,费用为 0.1 × $3 + 0.02 × $15 = $0.60。若其中 50,000 个输入 Token 确实命中缓存,则缓存部分按 $0.15/百万 Token 计算,基础模型费用会下降;但工具调用、Grounding、重试以及未命中的输入仍需单独计费。该例是价格演算,不是实测账单。
Gemini 4 Neon 的缓存为什么需要特别注意?
Neon 只支持隐式缓存,不支持显式创建和管理 cachedContents 缓存对象。Google 文档说明 Neon 的隐式缓存要求输入至少 4,096 Token;Google 开发者论坛的官方回复说明,缓存命中时输入 Token 可享 95% 折扣,但命中属于 best-effort,并非每次都能保证。对于反复提交相同长文档的评测、科研资料库和批处理任务,不应在预算中假设每次都会命中缓存,应在响应的 usage.total_cached_tokens 字段中核对实际缓存 Token。Google 还说明,在 Gemini 4 多轮/Agent 循环中,若新一轮相对上一轮新增内容不足 2,050 Token,系统会按标准输入价重新处理上一轮末尾的 2,050 Token;这意味着短小工具回合也可能影响缓存节省。Neon 开发者指南 · Google AI Developers Forum:Gemini 4 缓存讨论与官方回复
Gemini 4 Neon API 怎么调用?Python 接入示例
Gemini 4 Neon 的模型 ID 是 gemini-4-neon,使用 Google AI Studio 创建 Gemini API Key,再通过官方 Google Gen AI SDK 调用即可。Google 的 Gemini API Quickstart 推荐使用 google-genai,而不是旧版、已不再积极维护的 google-generativeai。以下示例使用 Gemini API Key 环境变量,不是 Google Cloud 企业项目凭据。Google Gemini API Python Quickstart · Google 官方 SDK 库说明
# 1. 安装官方 SDK
pip install -U google-genai
2. 设置 Google AI Studio 创建的 API Key
macOS / Linux:
export GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
Windows PowerShell:
$env:GEMINI_API_KEY="YOUR_GEMINI_API_KEY"
3. 调用 Gemini 4 Neon
from google import genai
client = genai.Client()
interaction = client.interactions.create(
model="gemini-4-neon",
input="分析这段代码中的并发风险,并给出最小修改方案。",
generation_config={"thinking_level": "medium"}
)
代码按 Google Gemini API Quickstart 的 Interactions API 结构整理,并使用 Neon 官方模型 ID 与 thinking_level 参数。需要在已开通 Neon 的付费 Gemini API 项目中运行;本文没有使用真实 Key 执行测试。Google Cloud Agent Platform 的企业调用还涉及项目、区域、IAM 与平台端点配置,不能把两种认证方式混为一谈。
High、XHigh、Medium、Low 应该怎么设置?
Neon 支持 Low、Medium、High(默认)和 XHigh。Google 开发指南建议:Low 用于高吞吐分类、路由、摘要和结构化信息抽取;Medium 适合通用编码、工具调用和文档问答;High 适合多步 Agent、代码生成和架构重构;XHigh 留给深度推理、数学证明、科学分析和最复杂的多文件工程任务。Google Neon thinking level 使用建议
Neon API 有哪些参数和协议限制?
Neon 的参数行为与旧版 Gemini 模型并不完全相同。Google 文档明确指出,Neon 不接受 thinking_level="minimal";迁移时应使用 thinking_level 控制推理强度,不要沿用旧模型的推理参数。自定义 temperature、top_p、top_k 在支持范围内会被忽略,超出范围则可能返回 HTTP 400。多轮 Function Calling 还需要保留模型返回的 thought_signature,并按文档要求组织并行工具调用,否则可能触发 400 或 MALFORMED_FUNCTION_CALL。迁移时不能只替换 Model ID。Neon API 规则与迁移检查表
“1M 输出 Token”也不等于一次普通请求默认可以直接生成 100 万 Token。Gemini API 中 Neon 的输入、思考和输出共享 1,048,576 Token 总预算;单个同步生成段最多 65,536 Token。Antigravity 的 Neon 上下文窗口则按其产品文档最高为 512K Token。更长输出需要启用 Long Decode:在 Interactions API 中提高 max_output_tokens,并使用 background=true(推荐)或最新 SDK 的自动续接;需要自定义控制时才手动处理 continuation_token。总输出不能超过 1,048,576 Token 减去输入占用。绝大多数聊天、摘要和普通代码任务不需要启用 Long Decode。
Neon 支持 OpenAI 兼容接口吗?
Google Cloud Gemini Enterprise Agent Platform 的文档将 Gemini 4 Neon 列入 OpenAI-compatible Chat Completions API 的支持模型列表;这是 Google Cloud 企业平台的兼容端点,不是标准 Gemini Developer API 的原生入口,也不代表所有第三方网关都自动支持 Neon 的全部能力。Google 对兼容端点也单独列出支持参数;Neon 的某些采样参数会被忽略,长输出续接和工具签名仍要按模型文档处理。Google Cloud:Using OpenAI libraries with Gemini Enterprise Agent Platform
如果你需要理解“能用 OpenAI SDK 调通”与“完整协议兼容”之间的区别,可以参考灵眸博客的 《OpenAI 兼容接口到底兼容什么?为什么能调用不代表完全兼容?》。尤其是 Tool Calling、SSE 流式事件、Usage 字段、错误码和多模态请求,必须按真实模型逐项测试。
开发者怎么评价 Neon?目前争论集中在哪里?
Neon 发布初期的开发者讨论,除了跑分,也集中在模型家族命名、价格层级和实际选型难度。11 月 19 日 Hacker News 的发布讨论中,用户反复提到 Carbon、Argon、Neon、Hydrogen 的名字难以直接映射到任务场景;也有人认为 Neon 取代 Argon 所在的性价比位置后,模型选择需要更清晰的任务说明。这些属于发布初期社区讨论,不代表所有开发者的使用结论。Hacker News:Gemini 4 Neon 讨论
另一个更实用的争议是缓存可控性。Google AI Developers Forum 有开发者分享 Gemini 4 系列隐式缓存命中比例偏低、重复提交长文档导致成本上升的案例;Google 员工在讨论中确认 Gemini 4 系列使用隐式缓存、缓存命中有折扣但不是保证。该案例最初测试的是 Hydrogen,不应冒充 Neon 的独立实测;它反映的是 Gemini 4 家族在重复上下文工作负载下需要验证缓存命中率这一共同问题。Google AI Developers Forum 原帖与官方回复
Neon 有哪些容易忽略的限制?
Neon 的 1M 上下文并不意味着每个请求都能一次性生成 1M Token,模型能力也不代表所有输入输出模态都支持。Google 模型卡列出的输入包括文本、图像、音频和视频,Gemini API 模型页还列出 PDF 输入;输出为文本。模型不支持图像生成、音频生成和 Live API。官方模型卡同时标注知识截止时间为 2026 年 3 月,并提醒模型仍可能产生幻觉。对于需要最新药品审批、临床指南、政策或市场数据的任务,必须使用检索和可追溯来源,不能把模型内置知识当作实时数据库。Google DeepMind Model Card · Google AI Studio 模型规格
从 Gemini 3 或旧版 Gemini API 迁移时,至少要检查四件事:第一,统一上下文预算由输入、思考和输出共同占用;第二,Neon 默认思考档位为 High,不再沿用旧版的 Medium 默认假设;第三,显式缓存参数需要移除,改用隐式缓存;第四,Function Calling 的历史记录要保留 thought_signature。Google 还建议删除不生效的 temperature、top_p、top_k,以及不支持的 frequency_penalty、presence_penalty 和多候选设置。Google Neon Migration Checklist
软件企业、生物医药和高校实验室应该怎样评估 Neon?
同一个模型不应该因为“适合企业”就被所有部门直接采用;评估应从任务、数据和失败成本三个维度开始。软件企业可以先选取历史 Issue、跨文件重构和线上故障定位任务,比较 Neon 与现有 Claude、Carbon 或 Hydrogen 的 PR 通过率、人工返工时间、P95 延迟和每次成功任务成本。Neon 在 CursorBench 的多文件 Agent 测试有优势,但上线前仍需用自己的仓库和测试集验证。
生物医药团队可以把 Neon 作为文献归纳、实验记录结构化、表格分析和科研资料交叉核对的候选工具,但不能把模型回答当作实验结论、临床决策或监管材料的唯一依据。未公开实验数据、患者信息、样本编号和商业秘密是否允许发送到外部模型,必须先按企业数据分级、合同和跨境要求审核。
高校实验室更需要可复现性。每次实验应保存模型 ID、思考档位、SDK 版本、Prompt、数据集版本、时间、Token 用量和评分规则;多人共享 API 经费时,还要设置项目级额度和用量记录。对于需要长期复现实验的团队,缓存是否命中、模型是否更新、API 计费口径是否改变,都应纳入实验记录。
企业如果同时使用 Gemini、Claude、GPT 等多个模型,还需要决定是分别接入官方 API、自己部署路由层,还是使用托管 API 网关。网关解决的是统一入口、密钥权限、模型路由和用量管理,不会自动降低上游 Token 单价,也不能凭空增加服务商尚未开放的模型。可以先阅读灵眸博客的 《AI API 网关是什么?企业如何统一接入和管理多个大模型?》,再结合团队是否需要多模型治理来决定;采购前还可以参考 《企业采购大模型 API,上线前要验证哪 8 项能力避免隐性成本》,检查并发、P95、重试、数据留存和 SLA。
就灵眸 AI 当前公开目录而言,2026 年 11 月 19 日可查到 Gemini 4 Argon、Carbon、Hydrogen 等模型,但公开 Gemini 模型列表尚未列出 Neon。因此,若要立即调用 Neon,应优先通过 Google 官方 Gemini API 验证;不要仅凭某个服务商写着“支持 Gemini”就推断它已经接入 Neon。对于还需要管理其他 Gemini、Claude、GPT 模型的团队,可以将灵眸 AI 作为多模型接入方案之一进行评估,但应以 实时模型目录、Gemini 接入页和真实调用结果为准。此处为灵眸 AI 自有产品信息,非第三方评测结论。
Gemini 4 Neon、Carbon、Hydrogen 和 Claude 怎么选?
| 实际需求 | 优先测试 | 为什么 | 上线前要核对 |
|---|---|---|---|
| 大批量、低延迟分类/路由/摘要 | Gemini 3.5 Flash-Lite | Google 官方将其定位于高吞吐、低延迟工作负载 | 吞吐、P95、错误率和总 Token 成本 |
| 多文件编码、复杂 Agent、企业分析 | Neon High | 在 CursorBench 4.1 中取得较好的分数/成本组合 | 真实仓库 PR 通过率、工具调用稳定性 |
| 最困难的多阶段推理或科研分析 | Neon XHigh / Carbon / Claude Fable 5.2 | 需要更深推理时再承担更高 Token 消耗 | 成功率提升是否抵消额外成本和等待时间 |
| 长周期、复杂工程项目 | Carbon 与 Neon 对照 | Carbon 面向更长周期的旗舰任务,Neon 更强调平衡 | 上下文管理、长程稳定性和返工 |
| 日常开发和常规 Bug 修复 | Hydrogen / Opus 5.5 / Neon Medium | 简单任务未必需要高推理预算 | 相同任务、相同验收标准下对照 |
| 多人科研团队共用 API | Neon 作为候选模型 + 项目级管理 | 可固定数据集和 Prompt 进行多模型实验 | 数据合规、可复现性、额度和账单归集 |
最稳妥的选型方法不是先选一个“最强模型”,而是建立 20—50 条真实任务的对照集:包括常规任务、历史失败任务、复杂边界任务和需要工具调用的任务。统一验收规则后,记录成功率、人工返工、任务耗时、P95、输入/输出/缓存 Token 和总费用。这样得到的“每次成功任务成本”比单独看榜单名次更接近生产决策。
Gemini 4 Neon 常见问题
Gemini 4 Neon API 有免费额度吗?
Google 官方 Gemini API 价格页将 Neon 标为 Free Tier 不可用,需要使用付费层。Gemini App 中的付费 Google AI Pro/Ultra 权益,以及 Antigravity 的计划可用性,与 Gemini API 账单分开计算;订阅使用权不等于 API 免费额度。
Gemini 4 Neon 的模型 ID 是什么?
模型 ID 为 gemini-4-neon。通过 Google AI Studio 创建 Gemini API Key,并使用官方 Google Gen AI SDK 或文档支持的 API 入口。
Gemini 4 Neon 的 API 价格是多少?
Standard 输入 $3、输出 $15/百万 Token;缓存命中输入 $0.15/百万 Token。Batch 和 Flex 标价为 $1.50/$7.50,Priority 为 $5.40/$27,具体以官方价格页为准。
Gemini 4 Neon 和 Carbon 哪个更好?
Carbon 面向更难、周期更长的任务;Neon 试图在能力与效率之间取得平衡。CursorBench 4.1 中 Neon Extra High 得 65.4%,Carbon High 得 61.5%;应结合实际任务和成本判断,而不是认为一个模型全面替代另一个。
Gemini 4 Neon 比 Claude Fable 5.2 强吗?
CursorBench 4.1 中 Neon Extra High 为 65.4%,Fable 5.2 Max 为 61.3%;这是特定多文件 Agent 任务的对比,不能外推到所有编程、研究和知识工作。
Gemini 4 Neon 的上下文窗口是 1M 吗?能一次输出 1M Token 吗?
Gemini API 的 Neon 输入、思考和输出共享 1,048,576 Token 总预算。单次同步输出最多 65,536 Token;更长输出需要启用 Long Decode 和后台执行。Antigravity 产品入口的 Neon 上下文窗口最高为 512K Token。
Gemini 4 Neon 能替代 Claude Code 吗?
两者不是同一类产品:Gemini 4 Neon 是模型,Claude Code 是编码 Agent 工具。更公平的比较方式是用同一代码仓库、Issue、工具权限和测试标准,对照 Antigravity(可用 Orchestrator Neon)与 Claude Code + 对应 Claude 模型的完成率、返工和总成本。
Gemini 4 Neon 支持显式上下文缓存吗?
不支持显式缓存对象,只支持隐式缓存。最低共享前缀为 4,096 Token,缓存命中有折扣但不能保证每次命中,生产任务应检查实际 cached token usage。
Neon 的思考档位应该选哪个?
Neon API 默认 High。Medium 适合交互式编码和延迟敏感工具调用;High 是复杂编码、Agent 和多模态知识工作的默认起点;XHigh 留给 High 无法解决的高难度多步工程、分析和科学任务。Zapier 的 657 项任务显示,XHigh 完成率最高,但成本也显著增加。
Antigravity 的 Orchestrator (Neon) 是什么?
它在同一对话里让 Neon 负责规划和复核,Hydrogen 负责代码实现、构建和测试;出现偏差时自动回到 Neon 重新规划。它不是并行多 Agent 群聊,也不能单独调整 Orchestrator 的 thinking level。
Gemini 4 Neon 在 Google AI Pro、Ultra 和 API 中都能用吗?
Gemini API 需要付费层;AI Studio 的产品入口可通过 Google AI Pro/Ultra 计划访问。Gemini App 的 Neon 面向 Google AI Pro/Ultra 订阅用户;Antigravity 的模型与 Orchestrator 可用性按 Pro、Ultra、Enterprise 等计划区分,且 Orchestrator (Neon) 不等于 Gemini API 额度。
Gemini 4 Neon 核心事实速查
- 发布时间:Google 于 2026 年 11 月 18 日发布 Gemini 4 Neon。Google 发布公告
- 模型 ID:
gemini-4-neon。Google Gemini API 价格页 - 标准 API 价格:输入 $3、输出 $15/百万 Token;缓存命中输入 $0.15/百万 Token。官方价格表
- 免费层:Neon 不在 Gemini API Free Tier 中;思考 Token 计入输出费用。官方价格表
- 思考档位:Low、Medium、High(默认)、XHigh。官方开发指南
- 上下文限制:输入和输出合计 1,048,576 Token;单段前台输出最多 65,536 Token。官方模型文档
- 缓存限制:只支持隐式缓存,不支持显式缓存对象;缓存命中并非保证。开发指南
- CursorBench 4.1:Neon Extra High 得 65.4%,Neon High 得 63.7%。CursorBench
- Zapier AutomationBench:Neon XHigh 在 657 项任务中完成 56.3%,任务成本估算 $1.69。Zapier 报告
- 知识截止:Google DeepMind 模型卡标注知识截止时间为 2026 年 3 月;需要最新事实时应使用检索或外部工具核验。Neon Model Card
参考资料与核验口径
- Google Blog:Introducing Gemini 4 Neon,2026-11-18。发布信息、官方定位、发布时 AA 排名与产品入口。
- Google DeepMind:Gemini 4 Neon Model Card,2026-11-18。模型用途、评测数据、知识截止和已知限制。
- Google AI for Developers:Gemini API Pricing,2026-11-19 查询。Standard、Batch、Flex、Priority 定价及免费层状态。
- Google Cloud:Gemini 4 Neon Model Documentation。上下文、API 能力、缓存与企业平台可用性。
- Google Cloud:Developer’s Guide to Gemini 4 Neon。SDK、思考档位、Long Decode、参数和多轮工具调用限制。
- Google Gemini API Quickstart(Python)。API Key、官方 SDK 和基础调用方法。
- Cursor:CursorBench 4.1。真实 Cursor 会话中的多文件 Agent 任务、分数、Token、步骤和成本。
- Artificial Analysis:Gemini 4 Neon。综合智能指数、延迟、输出速度和指数任务成本,实时排名查询日期 2026-11-19。
- Zapier:Gemini 4 Neon AutomationBench Results。657 项企业任务、严格最终状态判分、各档位完成率与估算成本。
- Hacker News:Gemini 4 Neon 发布讨论。开发者对模型命名、定位和使用选择的早期讨论。
- Google AI Developers Forum:Gemini 4 隐式缓存讨论。开发者反馈与 Google 员工对缓存行为的说明。
- Google Cloud:Using OpenAI Libraries with Gemini Enterprise Agent Platform。OpenAI-compatible Chat Completions 的支持模型和参数说明。
利益相关说明:本文由灵眸 AI 官方博客发布。涉及灵眸 AI 的段落仅说明截至 2026 年 11 月 19 日可公开核验的模型目录和内部相关文章,不代表灵眸已支持 Gemini 4 Neon,也不构成第三方性能评测。本文所有模型性能数字均标注其来源与测试口径;价格、模型可用性和 API 行为可能更新,生产接入前应重新核对官方文档与实际账单。